2010/06/03

回文数式作成プログラム

プログラム検証ツールを使って回文数式を作る。
例えば

42+46=64+24


// 回文数式作成
void main()
{
  int a1, a2, b1, b2, A1, A2, B1, B2;
  __CPROVER_assume(a1 > 0 && a1 <10 && a2 > 0 && a2 < 10 && b1 > 0 && b1 < 10 && b2 > 0 && b2 < 10);
  A1 = 10*a1 + a2;
  A2 = 10*a2 + a1;
  B1 = 10*b1 + b2;
  B2 = 10*b2 + b1;

  assert((A1+B1) != (A2+B2));
}

このプログラムをCBMCに掛ければ検証に失敗して

State 7 file anagram.c line 9 function main thread 0
----------------------------------------------------
  anagram::main::1::A1=42 (00000000000000000000000000101010)

State 8 file anagram.c line 10 function main thread 0
----------------------------------------------------
  anagram::main::1::A2=24 (00000000000000000000000000011000)

State 9 file anagram.c line 11 function main thread 0
----------------------------------------------------
  anagram::main::1::B1=46 (00000000000000000000000000101110)

State 10 file anagram.c line 12 function main thread 0
----------------------------------------------------
  anagram::main::1::B2=64 (00000000000000000000000001000000)

State 11 file anagram.c line 14 function main thread 0
----------------------------------------------------
  c::main::$tmp::tmp$1=FALSE

Violated property:
  file anagram.c line 14 function main
  assertion (A1+B1) != (A2+B2)
  FALSE

VERIFICATION FAILED

を得ることができる。

7/1 追加
魔方陣の解き方
CBMCで魔方陣を作成するプログラムが公開されています。

2010/05/30

単体テストできない関数

ヨーロッパの鉄道の安全規格[1]で一番厳しいSIL4ではブランチテストの100%カバレッジが求められるらしい。if文がネストしている複雑な関数の場合、そこにたどり着く入力データを作り出すのはなかなか難しい。CBMCを使って簡単にテストデータを生成する方法としてassert(0)を埋め込む方法がある。到達したい場所にassert(0)を仕込んで置いてCBMCで検証をすればCBMCが向きになってそこまで行って転けてくれるのでたどり着く方法が明確になる。必要があればprintf文も仕込んでおく、さらにテキストファイルに書き出すようにすれば、テストツールに掛けられる形でテストケースを得ることができる。


しかし、この方法も構造化されたプログラムでないとうまく行かない。構造化されたプログラムというのは、逐次、分岐、繰り返し構造だけでできているプログラムで、前方に跳ぶgoto文とか入れ子にならない繰り返しを持っていないプログラムである。今時、この様なプログラムはアセンブラで書かれたOSのディスパッチャぐらいだろう。ところが、並列性がある場合は任意のgoto文が動的に入るのと同じだからうまく行かない。要するに単体テストできないのと同じである。
グローバル変数を使っていても並列性が無ければ単体テストはできるが、それがvolatileなものだとそうはいかない。いちいちvolatile宣言しないとテスト以前にコンパイルがチャンとできているか心配になる。


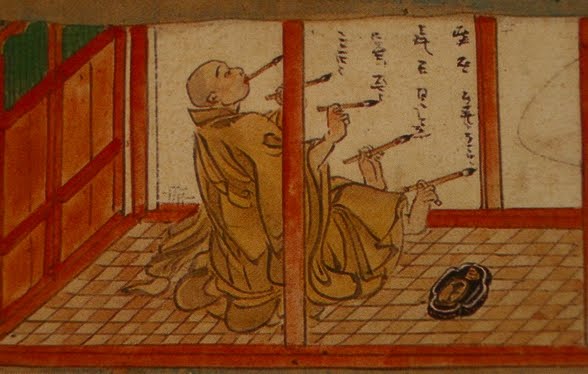
並列性がある場合には、節操なくグローバル数を使うことは控えなければならない。空海がどのように並列に文章を書くのか、文章だけはできていて出力だけが並列なのか、文章も考えながらつじつまの合うものを書き出すのか、これはアーキテクチャがぶれていては実現できない。
グローバル変数を多用して、並列性のあるシステムを作っていて、単体テストもチャンとやってますとか言う組織は多いけれどどんな単体テストをやっているのだろうか。

[1] European Committee forElectrotechnical Standardization. Railway Applications -
Communication, signalling and processing systems - Software forrailway control
and protection systems, http://www.cenelec.eu

2010/04/25

PDD その2

インタフェース誌にPDDのアイディアを書いた[1]。基本的な手順は、

1.      プログラムの目的を事後条件として表す。assert文で表現する。
2.      入力条件を場合分けし、それを事前条件とする。assume文で表現する。
3.      assume文の範囲でコーディングをおこない、検証をパスさせる。
4.      パスさせる過程で反例を分析して、分析結果はコーディングまたは事前条件に反映させる。
5.      残りの入力条件について同様に検証をパスさせる。
6.      全ての入力条件に対して検証が終わったら、事前条件を整理する。

基本的にはプログラムSを下のような形にして、Q∧S⇒Rを満たす様にする。QとRがプログラムの仕様である。入力条件は実装後はテスト条件として使用できる。

assume(Q);
S;
assert(R);

似たような形をコンピュータのセキュリティ改善に使っている論文があった[2]。この論文ではダイクストラの最弱事前条件を使っている。プログラム検証ツールを使用すれば自動化できる部分もありそうだ。

何もしないスキッププログラムの場合は、S=TrueなのでQ⇒Rになる。プログラム検証ツールは含意論理式の証明器としても使えることが分かったので、[1]ではちょっとした実験を紹介した。この実験を発展させて仕様書検証に使えないか検討してみた。すなわち、VDMで言うところの、陰関数定義をCで書いて検証できれば、仕様検証になる。やってみたら、確かにできそうだが、C言語で事前条件・事後条件を書くのが結構大変である。おかげで、述語論理を使えるVDMや時相論理を使えるモデル検査ツールの便利さが分かった。
モデル検査ツールはテストケースを用意しなくても検証できるが、述語論理式はテストケースが必要になる。と言うことはPDDの過程で作成するテスト条件が述語論理式をC言語で記述するヒントになるのかも知れない。
自然言語から直接Cの様なプログラム言語を書き出すのと、一端、述語論理式を経由するのでは、後者の方が絶対に楽なはずだ。壁の正体は何だろうか?

[1]新・組み込みソフトへの数理的アプローチ(第12回)
テストとプログラム検証――TDD(テスト駆動開発)におけるテスト
[2]B. V. Chess. Improving Computer Security using Extended Static Checking. In Proc of. 2002 IEEE Symposium on Security and Privacy, pages 160-173, 2002.

2010/04/18

レビューの信頼性

レビューする時、間違っているのに正しいとしてしまう間違いと、正しいのに間違っているとしてしまう間違いの二通りの間違いがある。前者をtype-1、後者をtype-2の間違いとする。またそれぞれの発生確率をe1、e2とする。要するにtype-1は見落とし、type-2は濡れ衣を着せてしまうことに対応する。

一人で2回レビューする時、1回目で間違いとしたものは見直さない場合には、見落としの確率は低くなるが、濡れ衣の確率は高くなる。xをe1またはe2としてプロットすると上図のようになる。つまり、見落としの方は二回連続で見落とさない限り検出されるので、見落とし確率はe1*e1になる。0 < e1 < 1なので小さくなりレビューの信頼性は向上する。濡れ衣は一度着せられてしまうと脱げないので、着せられてしまう確率は高くなるのである。濡れ衣を着せられない確率は1-e2で二回連続で着せられない確率は(1-e2)*(1-e2)になる。従って、一度でも着せられてしまう確率は1-(1-e2)*(1-e2)になる。これが上図の濡れ衣確率である。レビューしている本人にはどっちの間違いを犯したか判断は付かないというか、そもそも気づかないから間違いなのでどうしようもない。

逆に、一回目のことはすっかり忘れたことにして二回目のレビューをして両方で検出されたもののみを間違いとする場合は、今度は見落とし確率が高くなる。二人で1回レビューする場合で、二人が一致したもののも間違いとする場合も同様である。どちらかが間違いとしたものを間違いとする場合には、再び濡れ衣確率が高くなる。要するに必ずどちらかの間違い確率が高くなってしまう。

そこで、二人で二回レビューすることにすると、間違いのタイプによって挙動が変わる。見落とし型の間違いは以下のようになる。一回の間違い確率が0.38より大きいと信頼性が下がる。
濡れ衣型の間違いは以下のようになり、一回の間違い確率が0.61以上だと信頼性が下がる。
いずれにしても、おっちょこちょいな人が混じっているとレビューの信頼性は悪化する。と言うかやらない方が良いかも。

2010/03/31

TDD ⇒ PDD

ダイクストラは、テストでバグの存在は示せるがバグのないことは示せないと言っていた。一方で、TDDはテストを重ねながらプログラミングをおこない、用意したテストが全部通ったらプログラム完成と言うアプローチだ。と誤解しやすいが実は単なる開発プロセスに対する提案である(10/2)。
欲しいのはバグはあるかも知れないが取りあえず動作する綺麗なコードではなく、まずバグのないコードだ。
この点を改善するにはどうするか。実は良いアイディアが浮かんだ。自動テストツールではなく、プログラム検証ツールを使用して正しいことを証明しながらプログラミングをおこなうPDD(Proof driven development)だ。
プログラムSの証明とは、Qを事前条件、Rを事後条件として、{Q} S {P}が恒真であることを示すことだ。たとえば、二つの整数x, yを与えられてxが大きい値になるように、値を入れ替えるプログラムを書きたいとする。つまり


main()
{
  int x, y;

  assert(x >= y);
}

と言うことだ。これは関数仕様になる。Qは無しつまりQ = { T }、R = { x >= y }である。このソースコードをプログラム検証ツールのCBMCに掛けると当然


Violated property:
  file proof0.c line 8 function main
  assertion x >= y
  FALSE

VERIFICATION FAILED

となり正しくないことが証明される。次にもともとxの方が大きい場合をQに設定して検証する。つまり以下のプログラムを検証する。ここで、__CPROVER_assume( );はCBMCで前提条件を設定するディレクティブである。

main()
{
  int x, y, tmp;
  __CPROVER_assume( x>=y ); // Q1

  assert(x >= y);
}

これは成功する。従って x >= y の時は何もしなくて良いことが証明された。次にこのQが否定された場合を考える。¬(x >= y) だから(x < y)だ。

main()
{
  int x, y;
  // __CPROVER_assume( x>=y ); // Q1
  __CPROVER_assume( x < y ); // Q2 = ¬Q1

  if (x < y) {

  }
  assert(x >= y);
}


これは失敗するのでif文の中を書いて


main()
{
  int x, y, tmp;

  if (x < y) {
    tmp = x;
    x = y;
    y = tmp;
  }
  assert(x >= y);
}

とすると

>cbmc proof0.c
file proof0.c: Parsing
proof0.c
Converting
Type-checking proof0
Generating GOTO Program
Function Pointer Removal
Starting Bounded Model Checking
size of program expression: 18 assignments
simple slicing removed 1 assignments
Generated 1 VCC(s), 1 remaining after simplification
Passing problem to propositional reduction
Running propositional reduction
Solving with MiniSAT2 without simplifier
761 variables, 2109 clauses
SAT checker: negated claim is UNSATISFIABLE, i.e., holds
Runtime decision procedure: 0.034s
VERIFICATION SUCCESSFUL

となって正しいことが証明された。(x >= y)∨(x < y)は恒真なのでQ= {T }となり仕様が満たされた。
ダイクストラの時代にはプログラム検証器が無かったので手で証明しなければならず実用にはならなかったが、今は検証器がある。現在この手法の体系化を進めている。プログラミングが終わった時に、使い古しのテストケースとバグがあるかも知れないコードを得るTDDよりはPDDの方が良いことは言うまでもない。しかもdivision by zeroの様な普通のテストではできない検証も可能である。

2010/03/04

モデル化のセンス

Use Caseモデルを作ろうとするとDFDのような数珠つなぎの絵を描いてしまう、なぜだろうか、と聞かれたのでしばらく考えていた。たまたまUML&FMと言う形式手法関係のIEEEのワークショップの資料を見ていたところ下図のような絵があった。

きっとMulti-viewのところの知識か何かが不足しているのでそのようなことになるのではないか。例えば、DFDの使い方には長けているので何でも本人は書けてしまうし良く理解できている。何でもExcelで書いてしまう人などこのタイプは多い。自分用のメモとしては良いかも知れないが、他の人には理解してもらえない。変てこな図を書いていても作るものは作っているのであれば、抽象化軸やアーキテクチャ軸は頭の中に存在しているのだろう。Multi-view軸のところには色々なタイやグラムが並んでいるが目的に応じて使い分けることをUMLは意図している。下の図のような状況をUMLはある程度回避できるが、意味的な厳密さが無いので十分ではないと言うのがUML&FMでは話題になっている。

アーキテクチャとViewと言えばKruchtenの4+1 Viewが有名だ。


上記の図はオリジナルの論文[1]に掲載されているものでRational Softwareの資料では多少変更されている。


RUPにおけるそれぞれのビューの説明は以下のようになっている。

ユース ケース ビュー: アーキテクチャ上重要な振る舞い、クラス、技術面でのリスクを含むユース ケースとシナリオが含まれます。ユース ケース モデルのサブセットです。

論理ビュー: 最も重要な設計クラスとそのクラスからパッケージとサブシステムへの編成、これらのパッケージとサブシステムからレイヤへの編成が含まれます。ユース ケースの実現も含まれます。設計モデルのサブセットです。

実装ビュー: 実装モデルと、モジュールの観点からのパッケージとレイヤへの編成の概要が含まれます。実装ビューのパッケージとモジュールへの、(論理ビューの) パッケージとクラスの割り当ても記述されます。実装モデルのサブセットです。上の図ではコンポーネントビューと表示されている。

プロセス ビュー: 関与するタスク (プロセスとスレッド)、そのタスクの相互作用と構成、タスクへの設計オブジェクトとクラスの割り当ての記述が含まれます。このビューは、システムにかなりの程度の並行性がある場合にのみ使用する必要があります。RUP では、設計モデルのサブセットです。

配置ビュー: ほとんどの典型的なプラットフォーム構成のさまざまな物理ノード、物理ノードへの (プロセス ビューの) タスクの割り当ての記述が含まれます。このビューは、システムが分散される場合にのみ使用する必要があります。配置モデルのサブセットです。

それぞれのビューに向いたダイヤグラムがあるのでそれを使い分ければ良いモデルになるだろう。と言えれば美しいが、実際はUMLに存在するほとんどのダイヤグラムは論理ビュー向きである。動的な表現のために、シーケンス図とか状態図があるがタスク構造を表現するには不十分で、プロセスビューを記述することはできない。それでヨーロッパではADLが作られた。タスク構造を表現するための図としては、Gommaの図などがUML以前からあったが今は忘れられている。その意味ではプロセスビューが重要になる組込システムをUMLでモデリングしろ言われてもできないのが当然で、論理ビューの記述だけして実装に入ってしまう人の方がむしろ疑問が残る。
4+1ViewではユースケースビューからプロセスViewを構築することになっているが、ユースケースモデルで描くシーケンス図等の動的仕様とタスク設計の間にはまだギャップがある。どちらかというとユースケースモデルよりもプロブレムフレーム[3]による要求分析の方が動的な要求を正確に獲得できる気がする。ちなみに[4]は親子で書いた論文でプロブレムフレームとAlloyをどう融合するのかと言う面白い論文である。
プロブレムフレーム⇒Concurrency⇒Gomaaの流れが動的なモデリング、つまり動的アーキテクチャ構築には必要だと思う。ここでConcurrency[5]はLTASの教科書である。
参考文献
[2] Hassan Gomaa, Software Design Methods for Concurrent and Real-Time Systems.


[3] Problem Frames: Analysing and Structuring Software Development Problems (Addison-Wesley, 2001)


[5] Concurrency: State Models and Java Programs


2010/02/26

ソースコードの論理構造

要求を構造化した要求木と言う考え方を2010年2月号のインタフェース誌で紹介した。
要求管理ツールなどで要求のトレーサビリティを管理する例はあるが、それは単なる関係ではなくて論理的関係である。このことを利用して知識ベース化しようと言う考え方である。
今月のインタフェース誌(2010年4月号)はこの続きで、要求木の一番下のソースコードとの関係をプログラム検証ツールCBMC ( Bounded Model Checking for ANSI-C )を利用してソースコードも論理式にしてしまって要求木に組み込んで見ようと言う試みである。

上の図でCが左のソースコードの論理式表現になる。Rがアサーションでソースコードが満たすべき仕様になる。要求木の図ではReq6とかReq7にあたる。
CBMCはソースコードを論理化するのが目的ではなくPolySpaceと同じようなソースコード検証をするためのツールである。PolySpaceに比べるとフリーのツールなので使いづらいが、同じソースコードに対して同じ箇所の問題を指摘してくれる。ただし、PolySpaceと違って指摘の仕方がちょっと分かりづらい。また、Bounded Model Checkingを使っているので無限ループになることを検出するのは無理だ。

参考文献
[1] A Tool for Checking ANSI-C Programs,
http://www.kroening.com/papers/tacas2004.pdf
[2] astah 6.1 で「要求モデル」が目指している姿 T